Å merke maskinen: våpenkappløpet om KI-generert tekst
Vannmerking, deteksjon og den billige omskrivingen som setter begge ut av spill. Med et lite lokalt forsøk for å se sammenbruddet på nært hold.
- To hovedgrupper. Vannmerking bygger inn et skjult signal når teksten genereres, som Kirchenbauers grønne liste og Googles SynthID-Text. Deteksjon i etterkant analyserer ferdig tekst uten hjelp fra den som genererte den, som DetectGPT, Binoculars, GPTZero og OpenAIs nedlagte klassifikator. Vannmerking er langt sterkere, men dekker bare tekst fra en modell som samarbeider. Deteksjon kan brukes på all tekst, men er utsatt for feil.
- Begge har samme svake punkt: en omskriving. Krishna mfl. fikk DetectGPTs sann positiv-rate ned fra 70.3% til 4.6% ved en falsk positiv-rate på 1%. Sadasivan mfl. beviste en tilsvarende grense: Etter hvert som modellene blir bedre, nærmer selv den best mulige detektoren seg myntkast.
- Detektorene svikter på en skadelig måte. De overser KI-tekst og anklager mennesker feilaktig. Kostnaden rammer hardest dem som ikke skriver på morsmålet sitt: 61.3% falske positive resultater på TOEFL-tekster i en Stanford-studie. OpenAI la ned sin egen klassifikator, og Vanderbilt slo av Turnitins.
- Vannmerking har en verre feilmåte: forfalskning. For under femti dollar kan en angriper utlede hvordan et vannmerke virker og forfalske det, slik at leverandørens signatur settes på innhold leverandøren aldri har produsert.
- Institusjonene har dreid satsingen mot dokumentert opphav, en signert oversikt over hvor en fil kommer fra og hvordan den er redigert: C2PA / Content Credentials og kryptografisk signering ved opprettelse. Det svarer på «hvor kommer dette fra?», ikke «er dette falskt?». Det fungerer bedre for bilder enn for tekst, og bare når de som lager innholdet samarbeider.
- Regulering tvinger frem dette samarbeidet: artikkel 50 i EUs KI-forordning, med maskinlesbar merking fra august 2026, og Kinas regler om dobbel merking, som har vært i kraft siden september 2025. I USA snudde utviklingen da EO 14110 ble opphevet i januar 2025.
- Jeg kjørte et lite lokalt forsøk for å erfare sammenbruddet: generere KI-tekst med fire Ollama-modeller, bygge to zero-shot-detektorer og sette dem ut av spill med en omskriving. Resultatene står nedenfor.
Hvorfor merke tekst i det hele tatt
Folk vil vite om tekst kommer fra en maskin av tre grunner, og de trekker i ulike retninger.
Den første er akademisk redelighet. Den får mest oppmerksomhet fordi den berører folk mest direkte. En lærer med en bunke elevtekster vil ha et ja-eller-nei-svar om hver av dem. Det er det verst tenkelige bruksområdet for teknologien: Tekstene er korte, mye står på spill for den anklagede, og ett eneste falskt positivt resultat gjør reell skade på en virkelig elev.
Den andre er desinformasjon: botskrevet propaganda, falske anmeldelser, diskusjonstråder som gir seg ut for å være grasrotengasjement, og masseproduserte syntetiske nyheter. Her handler bruken mindre om å vurdere ett dokument og mer om å oppdage mønstre i store mengder innhold. Feil i enkeltvurderinger kan tolereres hvis det samlede signalet holder.
Den tredje får minst oppmerksomhet og kan ha størst konsekvenser: modellkollaps. Hvis neste generasjon modeller trenes på et nett fylt av forrige generasjons resultater, blir kvaliteten dårligere. Pålitelig dokumentasjon av opphav holder treningskorpuset rent. Dette er en interesse modellutviklerne selv har, og noe av grunnen til at Google har investert der andre har latt være.
Disse motivene stiller ulike krav til pålitelighet. Arbeid mot desinformasjon og med å holde treningskorpus rene kan leve med sannsynlighetsbaserte signaler på gruppenivå. Det kan ikke vurdering i klasserommet, men det er likevel der verktøyene markedsføres hardest og svikter mest.
Slik fungerer vannmerking
Et vannmerke er en bevisst, skjult skjevhet som legges inn mens teksten genereres. Bare den som kjenner hemmeligheten, kan lese det, og deteksjonen er en statistisk test mot en kjent regel.
Den grunnleggende metoden er Kirchenbauer mfl. sin «A Watermark for Large Language Models», fra en gruppe ved University of Maryland på ICML 2023 [1]. Før hvert token genereres, brukes en hash av det foregående tokenet som startverdi for en pseudotilfeldig oppdeling av vokabularet i en «grønn liste» og en «rød liste». Når neste token trekkes, legger metoden en liten, konstant forskyvning til de grønne tokenenes logit-verdier. Dette er et «mykt» vannmerke, som foretrekkes fremfor en «hard» variant som forbyr røde tokener, fordi det bevarer kvaliteten på tekst med lav entropi. Deteksjonen krever ikke tilgang til modellen: Den som kjenner regelen, teller grønne tokener og tester mot nullhypotesen om at teksten ble skrevet uten kjennskap til regelen. Menneskeskrevet tekst treffer grønne tokener så ofte som tilfeldighetene tilsier, mens vannmerket tekst gjør det langt oftere. Detektoren har åpen kildekode og fungerer på et nokså kort tekstutdrag.
Den mest avanserte løsningen i praktisk bruk er Google DeepMinds SynthID-Text, publisert i Nature i oktober 2024 [2]. Den bruker en mer raffinert innbygging kalt Tournament sampling. Mulige neste tokener går gjennom flere utslagsrunder, der tokenet med høyest pseudotilfeldig g-verdi går videre i hver runde. Vannmerket blir dermed en skjevhet i retning av tokener med høy g-verdi. Det bemerkelsesverdige er omfanget: Metoden kan konfigureres slik at den beviselig bevarer modellens utdatafordeling uten å forvrenge den. Google oppgir at den har vært i bruk i Gemini siden mai 2024, uten påviselig kvalitetsforskjell i brukertilbakemeldingene på rundt 20 millioner svar [2]. Kildekoden ble åpnet, og løsningen ble tatt inn i Hugging Face Transformers [3]. Så vidt jeg kjenner til, er dette det eneste vannmerket for tekst som er i bruk i industriell skala.
Kontrasten til OpenAI viser feltets sentrale dilemma. OpenAI har bekreftet at de har utviklet en metode for vannmerking av tekst, men sier de har en «veloverveid tilnærming» til å gjøre den tilgjengelig. Metoden er treffsikker ved lokale endringer som lett omskriving, men mindre robust ved gjennomgående endringer som oversettelse eller omformulering gjennom en annen modell [4]. Tallet «99.9% treffsikkerhet» og påstanden fra en spørreundersøkelse om at rundt 30% av ChatGPT-brukerne ville brukt produktet mindre, kommer fra Wall Street Journals journalistikk, ikke fra en uttalelse fra OpenAI. Jeg presiserer derfor kilden til disse opplysningene. Begrunnelsene selskapet oppgir for å holde igjen, er talende: fare for uforholdsmessige konsekvenser for dem som ikke har engelsk som morsmål, og at motiverte ondsinnede aktører lett kan omgå metoden. Samme teknologi, motsatt beslutning.
Alle vannmerker har to strukturelle svakheter, og Google oppgir begge for sitt eget system [3]: De virker bare på tekst fra en modell der eieren har valgt å vannmerke resultatene, noe som utelukker alle modeller med åpne vekter og alle ondsinnede modeller. De blir også svakere på tekst med lav entropi, som kode og korte faktasvar, der det ikke er rom for å forskyve genereringen.
Detektorene som ikke trenger vannmerker
Hvis du ikke kan regne med den som genererer teksten, må du arbeide baklengs fra den ferdige teksten. Dette er deteksjon i etterkant, der de fleste kommersielle produktene befinner seg og de fleste feilene oppstår.
Det eldste signalet er perpleksitet: Språkmodeller er konstruert slik at de lager mer forutsigbar tekst, med lavere perpleksitet, enn mennesker gjør. GPTZero, laget av bachelorstudenten Edward Tian ved Princeton og lansert 2. januar 2023 [5], kombinerer perpleksitet med «burstiness», variasjonen i kompleksitet fra setning til setning. Treffsikkerheten er omstridt, og verktøyet er beryktet for falske positive resultater på tekster skrevet av personer som ikke skriver på morsmålet sitt.
DetectGPT, fra en Stanford-gruppe på ICML 2023, har et mer prinsipielt grunnlag [6]. Hypotesen er at maskingenerert tekst ligger i områder med negativ krumning på kildemodellens loggsannsynlighetsflate. Metoden gjør derfor små endringer i teksten og sammenligner loggsannsynlighetene. Et stort fall tyder på at teksten er maskingenerert. Den oppnådde en AUROC på 0.95 ved deteksjon av falske nyheter laget av GPT-NeoX, mot 0.81 for den sterkeste tidligere referansemetoden. AUROC er en skår fra 0 til 1 for hvor godt to grupper skilles: 1 er perfekt, og 0.5 tilsvarer myntkast. Metoden krever imidlertid innsyn i modellen og mye regnekraft, siden den trenger både kildemodellens loggsannsynligheter og en egen modell som endrer teksten.
Den sterkeste detektoren jeg kjenner til som ikke trenger egen trening, er Binoculars, fra Hans mfl. på ICML 2024 [7]. Ideen er å dele én modells perpleksitet på en kryssperpleksitet: hvor overraskende en annen modells prediksjoner er for den første. Metoden bruker modellparet Falcon-7B / Falcon-7B-Instruct. Forholdstallet fjerner mye av støyen som gjør ren perpleksitet utilstrekkelig: over 90% deteksjon av ChatGPT-tekst ved en falsk positiv-rate på 0.01%, bedre enn GPTZero og Ghostbuster i deres tester [7]. Også Binoculars erkjenner begrensningene: Den oppdager pålitelig bare modeller som ligner modellene den bruker til skåring, menneskeskrevet tekst som modellene har memorert, kan feilklassifiseres som maskingenerert, og metoden er ikke robust mot målrettede angrep [7].
Det advarende eksempelet er OpenAIs egen AI Text Classifier, lansert 31. januar 2023 [8]. På et krevende testsett identifiserte den korrekt bare 26% av den KI-skrevne teksten, samtidig som den feilaktig merket 9% av den menneskeskrevne teksten som KI. OpenAI kalte den «ikke fullt pålitelig» og trakk den tilbake 20. juli 2023 på grunn av lav treffsikkerhet [8]. Selskapet som bygger modellene, klarte ikke pålitelig å oppdage sine egne resultater. Det bør dempe tilliten til enhver kommersiell detektor med et flott dashbord og en grønn hake.
Angrepet som setter alt ut av spill
Angrepet som gjør dette til et våpenkappløp forsvareren er i ferd med å tape, er en omskriving, til en nærmest ubetydelig kostnad.
Det sentrale resultatet kommer fra Krishna mfl., «Paraphrasing evades detectors of AI-generated text, but retrieval is an effective defense», på NeurIPS 2023 [9]. De bygde DIPPER, en omskrivingsmodell med 11 milliarder parametere, og kjørte KI-tekst gjennom den. For DetectGPT falt sann positiv-rate ved 1% falsk positiv-rate fra 70.3% til 4.6% [9]. Dette er andelen KI-tekst som oppdages når bare 1% av den menneskeskrevne teksten merkes feil. Det er ikke en svekkelse, men et sammenbrudd: En detektor som fanget opp sju av ti tekster, fanger nå opp færre enn én av tjue, og teksten betyr fortsatt det samme. Selv detektorer som søker etter samsvar med lagret tekst og er laget for å tåle omskriving, kan svekkes betydelig av rekursiv, altså gjentatt, omskriving [9][10].
Den mest generelle formuleringen av problemet finnes hos Sadasivan mfl., «Can AI-Generated Text Be Reliably Detected?», i TMLR [10]. Empirisk setter en modell som gjør lette omskrivinger, hele familien ut av spill: vannmerker, nevrale klassifikatorer og zero-shot-metoder. Teoretisk beviser de en grense som knytter AUROC for den best mulige detektoren til totalvariasjonsavstanden mellom fordelingene for menneskeskrevet og KI-generert tekst. Når modellene blir bedre og avstanden krymper mot null, kollapser dermed selv den optimale detektorens AUROC mot 0.5, altså tilfeldig gjetting [10]. I grensen er en tilstrekkelig god modell umulig å oppdage.
Dette resultatet blir ofte overdrevet. Chakraborty mfl. innvender at Sadasivans umulighetsresultat bare gjelder når fordelingene for menneskeskrevet og KI-generert tekst overlapper i hele støtteområdet sitt [11]. Så lenge de to ikke er identiske overalt, er deteksjon «nesten alltid mulig» med nok eksempler eller en lang nok sekvens. Den ærlige beskrivelsen er en avveining som handler om hvor mye data som trengs: Bedre modeller øker tekstmengden som kreves, kanskje til mer enn ett enkelt kort dokument kan gi. Det rammer der det gjør vondt, fordi tekstene samfunnet helst vil vurdere, en elevtekst eller en tweet, ligger i det vanskeligste området.
Vannmerker tåler omskriving litt bedre enn klassifikatorer, men bare litt. Maryland-gruppen som laget vannmerket med grønn liste, fant at vannmerket etter omfattende menneskelig omskriving fortsatt kan oppdages etter omtrent 800 tokener i gjennomsnitt, ved en falsk positiv-rate på 1e-5, fordi omskrivinger slipper gjennom bruddstykker av originalen [12]. Haken er tekstmengden: Korte svar havner under terskelen og slipper helt unna. Uavhengige granskninger av SynthID-Text kommer til samme konklusjon: Det tåler enkle redigeringer, men svekkes kraftig ved bevisst omskriving eller oversettelse [13]. Det avskrekker dem som vil omgå systemet uten innsats, men stopper ikke en motivert motstander.
Forfalskning er verre enn omgåelse: Den fabrikerer bevis i stedet for å skjule dem. Jovanovic, Staab og Vechev viste på ICML 2024 at man ved å sende forespørsler til et API med vannmerking kan utlede de hemmelige reglene for under femti dollar [14]. Mot én populær konfigurasjon lyktes de med forfalskning i over 80% av tilfellene. De genererte tekst, også skadelig innhold, som detektoren tilskrev den legitime leverandøren. Det samme stjålne vannmerket økte andelen vellykkede forsøk på å fjerne vannmerker fra rundt 1% til over 80% [14]. Mekanismen som skal bevise opphav, kan forfalskes for å fabrikkere et falskt opphav og gi en person eller et selskap skylden for ord de aldri skrev.
Feilen som gjør mest skade i hverdagen, er det falske positive resultatet. Liang mfl. ved Stanford fant i en studie publisert i Patterns en gjennomsnittlig falsk positiv-rate på 61.3% da sju detektorer vurderte TOEFL-tekster skrevet av personer uten engelsk som morsmål. Tekster skrevet av amerikanske åttendeklassinger ble derimot klassifisert riktig, med nesten ingen falske positive resultater [15]. Alle de sju detektorene feilmerket de samme 19.8% av de menneskeskrevne TOEFL-tekstene, og minst én detektor merket 97.8% av dem. Årsaken er at tekster skrevet på et andrespråk har mindre språklig variasjon og derfor ligner maskingenerert tekst. Det mest graverende er hvor lett dette snus: En instruks til en stor språkmodell om å «berike ordforrådet» reduserte falsk positiv-raten fra 61.3% til 11.6% [15]. Detektorene blir dermed både diskriminerende og enkle å lure. Vanderbilt slo av Turnitins KI-detektor i august 2023 og påpekte at selv en oppgitt falsk positiv-rate på 1% innebærer at rundt 750 av universitetets 75,000 årlige innleveringer merkes feil [16]. The Markup dokumenterte at studenter ved Johns Hopkins og Miami University måtte bevise sin uskyld ved hjelp av tidligere utkast. Internasjonale studenter risikerte å miste stipend og bli suspendert på en måte som truet visumet deres [17]. Bevisbyrden snus: Den anklagede må motbevise en maskin.
Forsøket: Tåler detektorene en omskriving?
Jeg ville erfare dette sammenbruddet, ikke bare vise til det. Derfor kjørte jeg et lite, helt lokalt forsøk for å gjenskape mønsteret i funnene uten eksterne tjenester.
Korpuset består av 90 tekstutdrag med samsvarende temaer, slik at selve emnet ikke blir et skjult kjennetegn: 45 menneskeskrevne utdrag fra Wikipedia-artikler (CC BY-SA) og 45 KI-tekster generert om de samme temaene med fire lokale Ollama-modeller (qwen2.5:7b, llama3.1:8b, mistral:7b, gemma2:9b). KI-tekstene er fordelt på de fire modellene for å unngå at én bestemt modellstil blir avgjørende. Markdown fjernes og mellomrom normaliseres først, slik at detektoren ikke kan jukse ved å bruke formateringen.
Jeg implementerte to zero-shot-detektorer med skåring fra andre modeller enn dem som genererte tekstene. Den første er en referansemetode basert på log-perpleksitet, det klassiske signalet i GLTR/DetectGPT-familien der KI-tekst gjerne skårer lavere. Den andre er Binoculars, forholdet mellom perpleksitet og kryssperpleksitet fra Hans mfl. [7]. Her bruker jeg det lille modellparet Qwen2.5-0.5B / Qwen2.5-0.5B-Instruct til skåringen, slik at forsøket kan kjøres på en bærbar PC. De små modellene gir noe lavere absolutt AUROC enn artikkelens Falcon-par, men det relative sammenbruddet, som er selve funnet, kommer fortsatt frem. Hver KI-tekst blir deretter omskrevet av en annen lokal modell enn den som skrev den. De menneskeskrevne tekstene forblir urørt, og detektoren må fortsatt identifisere de omskrevne KI-tekstene. Jeg måler AUROC og sann positiv-rate ved faste falske positiv-rater på 1% og 5%. Dette beregnes to ganger per detektor: opprinnelig KI-tekst mot menneskeskrevet tekst og omskrevet KI-tekst mot menneskeskrevet tekst, hver med et 95% konfidensintervall beregnet med bootstrap (1000 nye utvalg).
Forventningen min var den litteraturen pekte mot: et tydelig skille før angrepet, deretter et kraftig fall etter omskriving, med et større sammenbrudd for ren perpleksitet enn for Binoculars [9][10]. Det var en hypotese, ikke et resultat.
Skillet var der før angrepet. Referansemetoden med log-perpleksitet oppnådde en AUROC på 0.96 (95% konfidensintervall 0.92 til 0.99) når den skilte opprinnelig KI-tekst fra menneskeskrevet tekst. Binoculars oppnådde 0.90 (0.82 til 0.95). Ved en streng falsk positiv-rate på 1% fanget begge opp 60% av KI-tekstene. Når temaet er kontrollert for, oppdager altså selv en liten lokal detektor ubehandlet modelltekst mesteparten av tiden.
Så lot jeg tekstene bli omskrevet, og begge detektorene brøt sammen. Log-perpleksitet falt fra 0.96 til 0.65 AUROC (0.53 til 0.76), og Binoculars falt fra 0.90 til 0.65 (0.54 til 0.77). En AUROC på 0.65 er nærmere myntkast (0.50) enn de 0.95 eller mer man burde ønske seg før man handler på grunnlag av et utslag. Sann positiv-raten er tallet som bør bekymre alle som tar dette i bruk: Ved en falsk positiv-rate på 1% falt deteksjonen av KI-tekst fra 60% til rundt 10% for begge detektorene. Ved en mer romslig falsk positiv-rate på 5% falt log-perpleksitet fra 82% til 10% og Binoculars fra 69% til 15%. Én gjennomkjøring i en annen lokal modell, uten DIPPER, finjustering eller menneskelig redigering, tok detektorer som fanget opp det meste av den maskingenererte teksten, ned til omtrent ett utdrag av ti. Det er samme mønster som fallet fra 70.3% til 4.6% hos Krishna mfl. [9], gjenskapt på en bærbar PC.
To ting overrasket meg, og begge gikk imot mine egne forventninger. For det første slo ikke den sterke detektoren den svake: Med et modellpar på 0.5B til skåringen lå Binoculars litt under referansemetoden med ren perpleksitet før angrepet og endte på samme sted etterpå. Fordelen i forskningsartikkelen kommer nemlig fra mye større skåringsmodeller. For det andre var sammenbruddet symmetrisk: Jeg hadde ventet at perpleksitet skulle stupe mens Binoculars ble mer gradvis svekket. Begge endte imidlertid på den samme nesten ubrukelige AUROC-verdien, fordi angrepet flytter selve teksten nærmere fordelingen for menneskeskrevet tekst, uavhengig av hvilket statistisk mål man beregner.
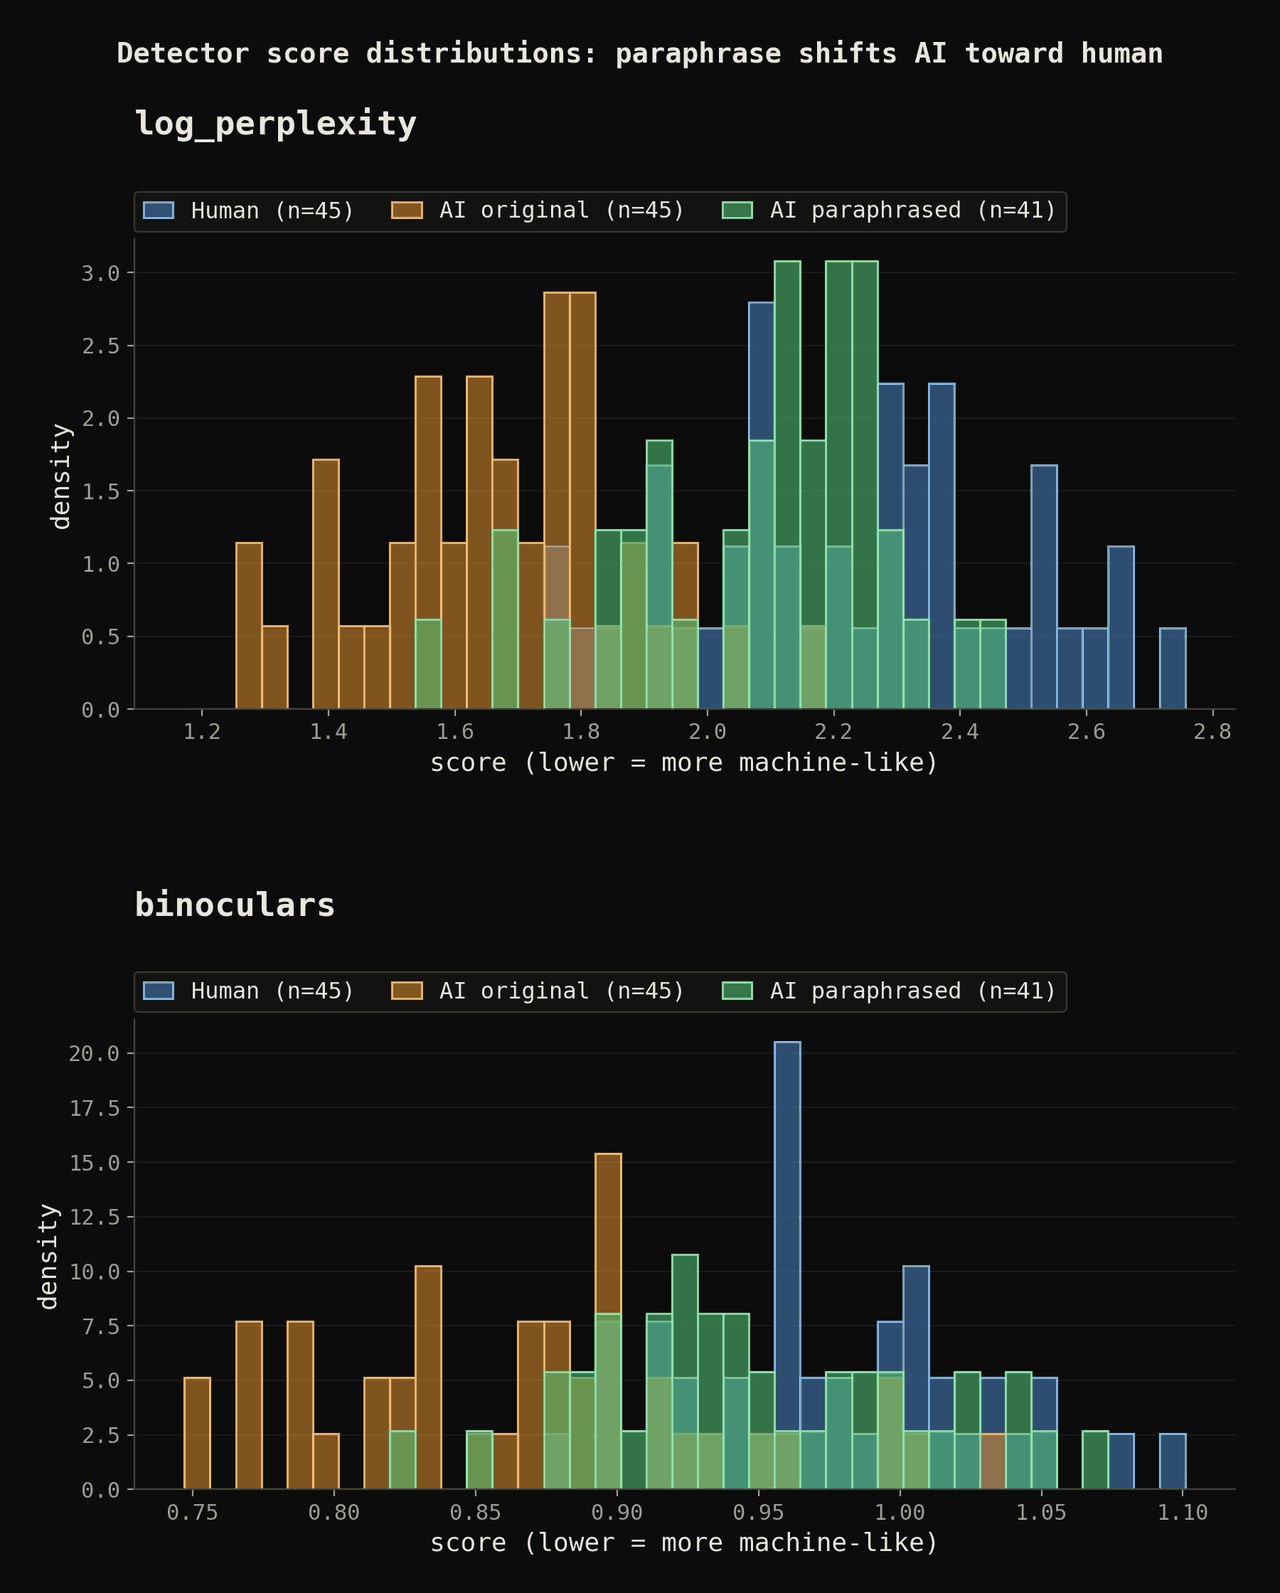
Etter omskrivingen er det ikke først og fremst slik at KI-teksten skjuler seg for detektoren. Ut fra det eneste målet detektoren har, er den blitt menneskeskrevet.
Forbeholdene er reelle. Få tekstutdrag gir brede konfidensintervaller, særlig i halen der falsk positiv-raten er 1%, og det lille modellparet til skåringen gjør at mine absolutte tall ligger under de publiserte Falcon-resultatene. Moderne modeller kan ha memorert noe Wikipedia-tekst. Det gjør deteksjonen lettere og gjør derfor fallet etter angrepet til en konservativ nedre grense fremfor en overdrivelse. Ingen av disse forbeholdene endrer retningen, og det er poenget.
Dokumentert opphav i stedet for deteksjon
Hvis deteksjon er et kappløp forsvareren ikke kan vinne, er det pragmatiske grepet å slutte å løpe. Feltets navn på alternativet er proveniens, altså dokumentert opphav. Deteksjon anslår om ferdig innhold er falskt. Den er sannsynlighetsbasert, svekkes når genereringsmodellene blir bedre, og er sårbar for omgåelse og forfalskning. Dokumentert opphav innebærer i stedet at en kontrollerbar, kryptografisk signert oversikt over opprinnelse og redigeringshistorikk legges ved idet innholdet opprettes, og følger filen videre. Spørsmålet er ikke «er dette falskt?», men «hvor kommer dette fra, og hva er gjort med det?»
Standarden er C2PA, Coalition for Content Provenance and Authenticity, med «Content Credentials» som navnet brukerne møter. Den ble grunnlagt i februar 2021 av Adobe, Arm, BBC, Intel, Microsoft og Truepic gjennom en sammenslåing av Adobes Content Authenticity Initiative og Microsoft/BBCs Project Origin, og drives under Linux Foundation [18]. Mekanismen bygger på ordinær kryptografi: Når innhold opprettes, beregnes en hash for hver fil, og denne signeres inn i et manifest som avslører senere endringer. Manifestet registrerer opplysninger som verktøyene som ble brukt, datoen og redigeringene som ble gjort. Standard infrastruktur for offentlige nøkler gjør at brukeren stoler på underskriverens identitet, ikke på pikslene [19]. Hvis innhold endres etter signering, stemmer ikke hashen lenger, og alle visningsverktøy som følger standarden, varsler om det. Content Authenticity Initiative er åpen om at dette ikke er en detektor for falskt innhold: De beskriver Content Credentials som «en slags innholdsdeklarasjon for digitalt innhold», påpeker at deteksjonsverktøy «kan være upålitelige», og sier at opplysningene «ikke er ment å fastslå om et bestemt innhold er ‘ekte’» [19]. Dokumentert opphav beviser hvem som signerte og hva som ble endret. Det beviser ikke at innholdet er sant, og fravær av slike opplysninger beviser ingenting.
Dokumentert opphav hjelper bilder mer enn tekst, av en fysisk grunn. Et bilde inneholder mange biter, så et manifest kan bygges inn og, i «varige» løsninger, kobles til et vannmerke i pikslene som overlever ny koding. Tekst inneholder lite data og er enkel å skrive inn på nytt. Kopier ordene til et nytt dokument, så er hver eneste signerte bit borte. Derfor omfatter SynthID bilde, lyd og video i tillegg til tekst. Vannmerkene som bygges inn i piksler eller lydsampler, tåler vanlige transformasjoner, mens tekstvannmerket forblir det svakeste medlemmet av familien [3]. Google oppgir at SynthID hadde merket over 10 milliarder innholdselementer per mai 2025, et tall jeg gjengir som leverandørens egen opplysning, og har lansert en detektorportal for sine egne vannmerker [20].
Begrensningen dokumentert opphav og vannmerking deler, er samarbeid: Begge er avhengige av at den som genererer innholdet, velger å merke det. Ingen av dem dekker innhold fra en modell der eieren ikke har valgt å delta, eller der metadataene er fjernet. Men dette samarbeidet er helt avgjørende, og derfor er neste grep regulering.
Reglene som skal sikre merking
Lover brukes nå til å få på plass samarbeidet teknologien forutsetter, og tre regelverk er uenige om hvor hardt man skal gå til verks.
Det mest konkrete er artikkel 50 i EUs KI-forordning [21]. Leverandører av generativ KI må sikre at resultatene er «merket i et maskinlesbart format og kan oppdages som kunstig generert eller manipulert», med løsninger som er «effektive, interoperable, robuste og pålitelige så langt det er teknisk gjennomførbart». De som tar systemene i bruk, må opplyse om KI-genererte deepfakes og om KI-generert tekst om spørsmål av offentlig interesse, med mindre et menneske har tatt redaksjonelt ansvar. Bestemmelsene får anvendelse 2. august 2026 [22]. Formuleringen «så langt det er teknisk gjennomførbart» gjør mye arbeid i det stille: Lovgiverne vet at teknologien er ufullkommen, og har skrevet denne ufullkommenheten inn i plikten.
USA gikk i motsatt retning. Executive Order 14110, undertegnet av Biden 30. oktober 2023, ga NIST og handelsdepartementet i oppdrag å utarbeide veiledning om autentisering av innhold og vannmerking [23]. NIST leverte: NIST AI 100-4, «Reducing Risks Posed by Synthetic Content», publisert 20. november 2024, beskrev autentisering av innhold, sporing av opphav og deteksjon som et system med flere lag fremfor konkurrerende alternativer [24]. Så snudde politikken: President Trump opphevet EO 14110 den 20. januar 2025, få timer etter innsettelsen, og erstattet den noen dager senere med «Removing Barriers to American Leadership in Artificial Intelligence» [23]. NIST-rapporten består som publisert veiledning, men den føderale drivkraften bak USAs vannmerkingspolitikk er kraftig svekket. Alle som fremstiller EO 14110 som gjeldende politikk i 2026, tar ganske enkelt feil. Den er historie.
Kina gikk lengst. Cyberspace Administration of China publiserte «Measures for Labeling AI-Generated Synthetic Content», sammen med en obligatorisk nasjonal standard, 14. mars 2025. Reglene har vært i kraft siden 1. september 2025 [25]. Kravet er todelt: eksplisitte merker i form av synlig tekst eller grafikk, og implisitte merker i form av et innebygd vannmerke eller metadata med leverandørens navn og en innholdsidentifikator. Distribusjonsplattformer må dessuten kontrollere innholdet for slike merker før publisering og merke innhold de mistenker er umerket KI-innhold [26]. Tre reguleringsmyndigheter, tre filosofier: EU krever maskinlesbar merking, Kina krever synlige og innebygde merker samt plattformkontroller, og USA krever foreløpig ingenting.
Etter å ha gått gjennom litteraturen og sett mine egne detektorer bukke under for en omskrivingsinstruks på én linje, er dette standpunktet mitt.
Deteksjon av KI-tekst som en ja-eller-nei-dom over ett enkelt kort dokument er ikke et problem som lar seg løse, og vi bør slutte å selge det som det. Teorien sier at den optimale detektoren nærmer seg tilfeldighet etter hvert som modellene blir bedre [10]. Praksis sier at en gratis omskriving allerede tar deg det meste av veien dit [9]. Og feilen er ingen harmløs glipp, men en uriktig anklage mot dem som har dårligst forutsetninger for å forsvare seg [15]. Et verktøy som både er ineffektivt mot de motiverte og diskriminerer de uskyldige, gjør mer skade enn nytte i et klasserom. OpenAI gjorde derfor rett i å legge ned sin egen klassifikator, og institusjonene som slo av Turnitins, var tidlig ute med å forstå problemet.
Vannmerking er klart bedre, og SynthID-Text er en betydelig ingeniørprestasjon: umerkelig, uten kvalitetstap og i bruk i et omfang ingen andre har matchet. Men den forsvarlige bruken er å avskrekke ukritisk gjenbruk og hjelpe modellutviklerne med å holde treningskorpus rene, ikke å fungere som teknisk bevis når noen aktivt prøver å omgå systemet. Metoden bryter sammen ved omskriving av kort tekst og dekker bare modeller som samarbeider. Resultatene om forfalskning viser dessuten at den like gjerne kan fabrikkere falske bevis som bekrefte et ekte opphav. Dokumentert opphav er det mest forsvarlige å satse på, nettopp fordi det lover minst: Det hevder ikke å oppdage noe, bare å tilby en signert og kontrollerbar oversikt over opprinnelsen fra dem som selv har valgt å signere, med en åpen erkjennelse av at manglende signatur ikke betyr noe. Det vil fungere bedre for bilder enn for tekst så lenge tekst er noen få kilobyte som kan skrives inn på nytt på ett minutt, en forskjell som trolig er varig.
Det realistiske sluttresultatet har flere lag, akkurat slik NIST beskrev det [24]: varig dokumentasjon av opphav der det lar seg etablere, innebygd vannmerking der den som genererer innholdet samarbeider, og deteksjon bare som en usikker siste kontroll som aldri bør avgjøre noens karriere eller karakter. Den ærlige setningen som bør følge enhver dom over KI-tekst, er den feltet stadig prøver å unngå: Vi kan ikke være sikre. Når man nekter å innrømme det, særlig i skolens retningslinjer, ender man med at en elev må bevise at noe ikke har skjedd, overfor en maskin som tok feil 61% av tiden om mennesker som skriver som eleven selv. Jeg vil heller levere usikkerheten åpent enn å kamuflere den bak en grønn hake.
Referanser
- Kirchenbauer, Geiping, Wen, Katz, Miers, Goldstein. "A Watermark for Large Language Models." https://arxiv.org/abs/2301.10226
- Dathathri et al. (Google DeepMind). "Scalable watermarking for identifying large language model outputs." Nature, 2024. https://www.nature.com/articles/s41586-024-08025-4
- Google / Hugging Face. "Introducing SynthID Text." https://huggingface.co/blog/synthid-text
- TechCrunch. "OpenAI says it's taking a 'deliberate approach' to releasing tools that can detect writing from ChatGPT." https://techcrunch.com/2024/08/04/openai-says-its-taking-a-deliberate-approach-to-releasing-tools-that-can-detect-writing-from-chatgpt/
- Wikipedia. "GPTZero." https://en.wikipedia.org/wiki/GPTZero
- Mitchell, Lee, Khazatsky, Manning, Finn. "DetectGPT: Zero-Shot Machine-Generated Text Detection using Probability Curvature." https://arxiv.org/abs/2301.11305
- Hans, Schwarzschild, Cherepanova, Kazemi, Saha, Goldblum, Geiping, Goldstein. "Spotting LLMs with Binoculars: Zero-Shot Detection of Machine-Generated Text." https://arxiv.org/abs/2401.12070
- TechCrunch. "OpenAI scuttles AI-written text detector over 'low rate of accuracy'." https://techcrunch.com/2023/07/25/openai-scuttles-ai-written-text-detector-over-low-rate-of-accuracy/
- Krishna, Song, Karpinska, Wieting, Iyyer. "Paraphrasing evades detectors of AI-generated text, but retrieval is an effective defense." https://arxiv.org/abs/2303.13408
- Sadasivan, Kumar, Balasubramanian, Wang, Feizi. "Can AI-Generated Text Be Reliably Detected?" https://arxiv.org/abs/2303.11156
- Chakraborty et al. "On the Possibilities of AI-Generated Text Detection." https://arxiv.org/abs/2304.04736
- Kirchenbauer, Geiping, Wen, Shu, Saifullah, Kong, Fernando, Saha, Goldblum, Goldstein. "On the Reliability of Watermarks for Large Language Models." https://arxiv.org/abs/2306.04634
- "Robustness Assessment and Enhancement of Text Watermarking for Google's SynthID." https://arxiv.org/abs/2508.20228
- Jovanovic, Staab, Vechev. "Watermark Stealing in Large Language Models." https://watermark-stealing.org/
- Liang et al. "GPT detectors are biased against non-native English writers." Patterns, 2023. https://pmc.ncbi.nlm.nih.gov/articles/PMC10382961/
- Vanderbilt University. "Guidance on AI detection and why we're disabling Turnitin's AI detector." https://www.vanderbilt.edu/brightspace/2023/08/16/guidance-on-ai-detection-and-why-were-disabling-turnitins-ai-detector/
- The Markup. "AI Detection Tools Falsely Accuse International Students of Cheating." https://themarkup.org/machine-learning/2023/08/14/ai-detection-tools-falsely-accuse-international-students-of-cheating
- C2PA. "C2PA founding press release." https://c2pa.org/c2pa-founding-press-release/
- Content Authenticity Initiative. "How it works." https://contentauthenticity.org/how-it-works
- Google. "SynthID AI content detector." https://blog.google/innovation-and-ai/products/google-synthid-ai-content-detector/
- EU AI Act. "Article 50: Transparency Obligations for Providers and Deployers of Certain AI Systems." https://artificialintelligenceact.eu/article/50/
- EU AI Act. "Transparency rules (Article 50)." https://artificialintelligenceact.eu/transparency-rules-article-50/
- Wikipedia. "Executive Order 14110." https://en.wikipedia.org/wiki/Executive_Order_14110
- NIST. "NIST AI 100-4: Reducing Risks Posed by Synthetic Content." https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-4.pdf (engelsk)
- Inside Privacy (Covington). "China Releases New Labeling Requirements for AI-Generated Content." https://www.insideprivacy.com/international/china/china-releases-new-labeling-requirements-for-ai-generated-content/
- Bird & Bird. "New AI content labelling rules in China: what are they and how do they compare to the EU AI Act." https://www.twobirds.com/en/insights/2025/new-ai-content-labelling-rules-in-china-what-are-they-and-how-do-they-compare-to-the-eu-ai-act